















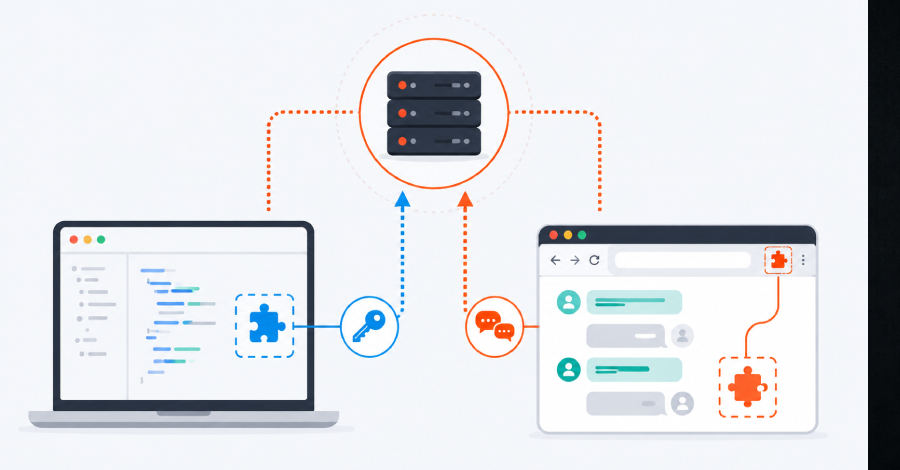
محققان امنیت سایبری از شناسایی یک کمپین بدافزاری هماهنگ در مارکتپلیس JetBrains خبر دادهاند که با انتشار دستکم 15 پلاگین مخرب، کلیدهای API هوش مصنوعی مورد استفاده توسعهدهندگان را سرقت میکند
گزارش جدید شرکت SafeBreach از شناسایی یک تکنیک نوین برای سوءاستفاده از قابلیت خلاصهسازی اعلانهای پیامرسان در دستیار هوش مصنوعی گوگل جمنای (Google Gemini) خبر میدهد؛ روشی که مهاجمان با بهرهگیری از آن توانستهاند دستورات مخرب را در پیامهای دریافتی پنهان کرده
آسیبپذیری ChromaDB با شناسه CVE-2026-45829 و شدت بحرانی (Critical) در نسخه Python مبتنی بر FastAPI شناسایی شده است؛ ضعفی که به مهاجمان احراز هویتنشده اجازه میدهد کد دلخواه (Arbitrary Code) را روی سرورهای در معرض اینترنت اجرا کنند
گزارش جدید تیم تحلیل تهدیدات گوگل (GTIG) نشان میدهد مهاجمان سایبری اکنون از مدلهای زبانی بزرگ (LLM) برای توسعه اکسپلویت با هوش مصنوعی، شناسایی آسیبپذیریها و خودکارسازی عملیات نفوذ استفاده میکنند. این روند نشان میدهد توسعه اکسپلویت با هوش مصنوعی دیگر یک سناریوی نظری نیست، بلکه به بخشی از ابزار عملیاتی عوامل تهدید تبدیل شده است و میتواند توازن سنتی میان مهاجمان و تیمهای دفاع سایبری را تغییر دهد.
ظهور نسل جدید مدلهای زبانی بزرگ (LLM) مانند Claude Mythos از شرکت Anthropic و GPT‑5.5 از OpenAI باعث شکلگیری بحثهای گستردهای در جامعه امنیت سایبری شده است.
خستگی از هشدارها مسئلهی مهمی است. تحقیقات اخیر صنعتی از سوی شرکت ارائهدهندهی پلتفرم دادههای امنیتی Devo نشان داد که ۸۳٪ از تحلیلگران امنیتی از حجم زیاد هشدارها، هشدارهای مثبت کاذب و کمبود اطلاعات، احساس سردرگمی میکنند. و آنها زمان قابل توجهی را صرف جمعآوری دستی و مرتبط کردن شواهد
محققان امنیت سایبری از شناسایی یک کمپین بدافزاری هماهنگ در مارکتپلیس JetBrains خبر دادهاند که با انتشار دستکم 15 پلاگین مخرب، کلیدهای API هوش مصنوعی مورد استفاده توسعهدهندگان را سرقت میکند
گزارش جدید شرکت SafeBreach از شناسایی یک تکنیک نوین برای سوءاستفاده از قابلیت خلاصهسازی اعلانهای پیامرسان در دستیار هوش مصنوعی گوگل جمنای (Google Gemini) خبر میدهد؛ روشی که مهاجمان با بهرهگیری از آن توانستهاند دستورات مخرب را در پیامهای دریافتی پنهان کرده
آسیبپذیری ChromaDB با شناسه CVE-2026-45829 و شدت بحرانی (Critical) در نسخه Python مبتنی بر FastAPI شناسایی شده است؛ ضعفی که به مهاجمان احراز هویتنشده اجازه میدهد کد دلخواه (Arbitrary Code) را روی سرورهای در معرض اینترنت اجرا کنند
گزارش جدید تیم تحلیل تهدیدات گوگل (GTIG) نشان میدهد مهاجمان سایبری اکنون از مدلهای زبانی بزرگ (LLM) برای توسعه اکسپلویت با هوش مصنوعی، شناسایی آسیبپذیریها و خودکارسازی عملیات نفوذ استفاده میکنند. این روند نشان میدهد توسعه اکسپلویت با هوش مصنوعی دیگر یک سناریوی نظری نیست، بلکه به بخشی از ابزار عملیاتی عوامل تهدید تبدیل شده است و میتواند توازن سنتی میان مهاجمان و تیمهای دفاع سایبری را تغییر دهد.
ظهور نسل جدید مدلهای زبانی بزرگ (LLM) مانند Claude Mythos از شرکت Anthropic و GPT‑5.5 از OpenAI باعث شکلگیری بحثهای گستردهای در جامعه امنیت سایبری شده است.
خستگی از هشدارها مسئلهی مهمی است. تحقیقات اخیر صنعتی از سوی شرکت ارائهدهندهی پلتفرم دادههای امنیتی Devo نشان داد که ۸۳٪ از تحلیلگران امنیتی از حجم زیاد هشدارها، هشدارهای مثبت کاذب و کمبود اطلاعات، احساس سردرگمی میکنند. و آنها زمان قابل توجهی را صرف جمعآوری دستی و مرتبط کردن شواهد